머신러닝에 맡겨도 되는 전략은 따로 있어요
“머신러닝으로 트레이딩하면 되지 않나요?” 이 질문을 정말 많이 받아요. 그리고 제가 몇 년 동안 직접 해 본 결론은 좀 김빠지는 쪽이에요. 되는 전략이 있고, 안 되는 전략이 있는데, 그걸 가르는 건 모델이 아니라 전략의 꼴이더라고요.
더 좋은 모델을 찾느라 쓴 시간보다, “이 전략은 애초에 기계가 배울 수 있는 꼴인가”를 먼저 묻는 게 훨씬 값쌌어요. 오늘은 그 기준을 정리해 보려고 해요.
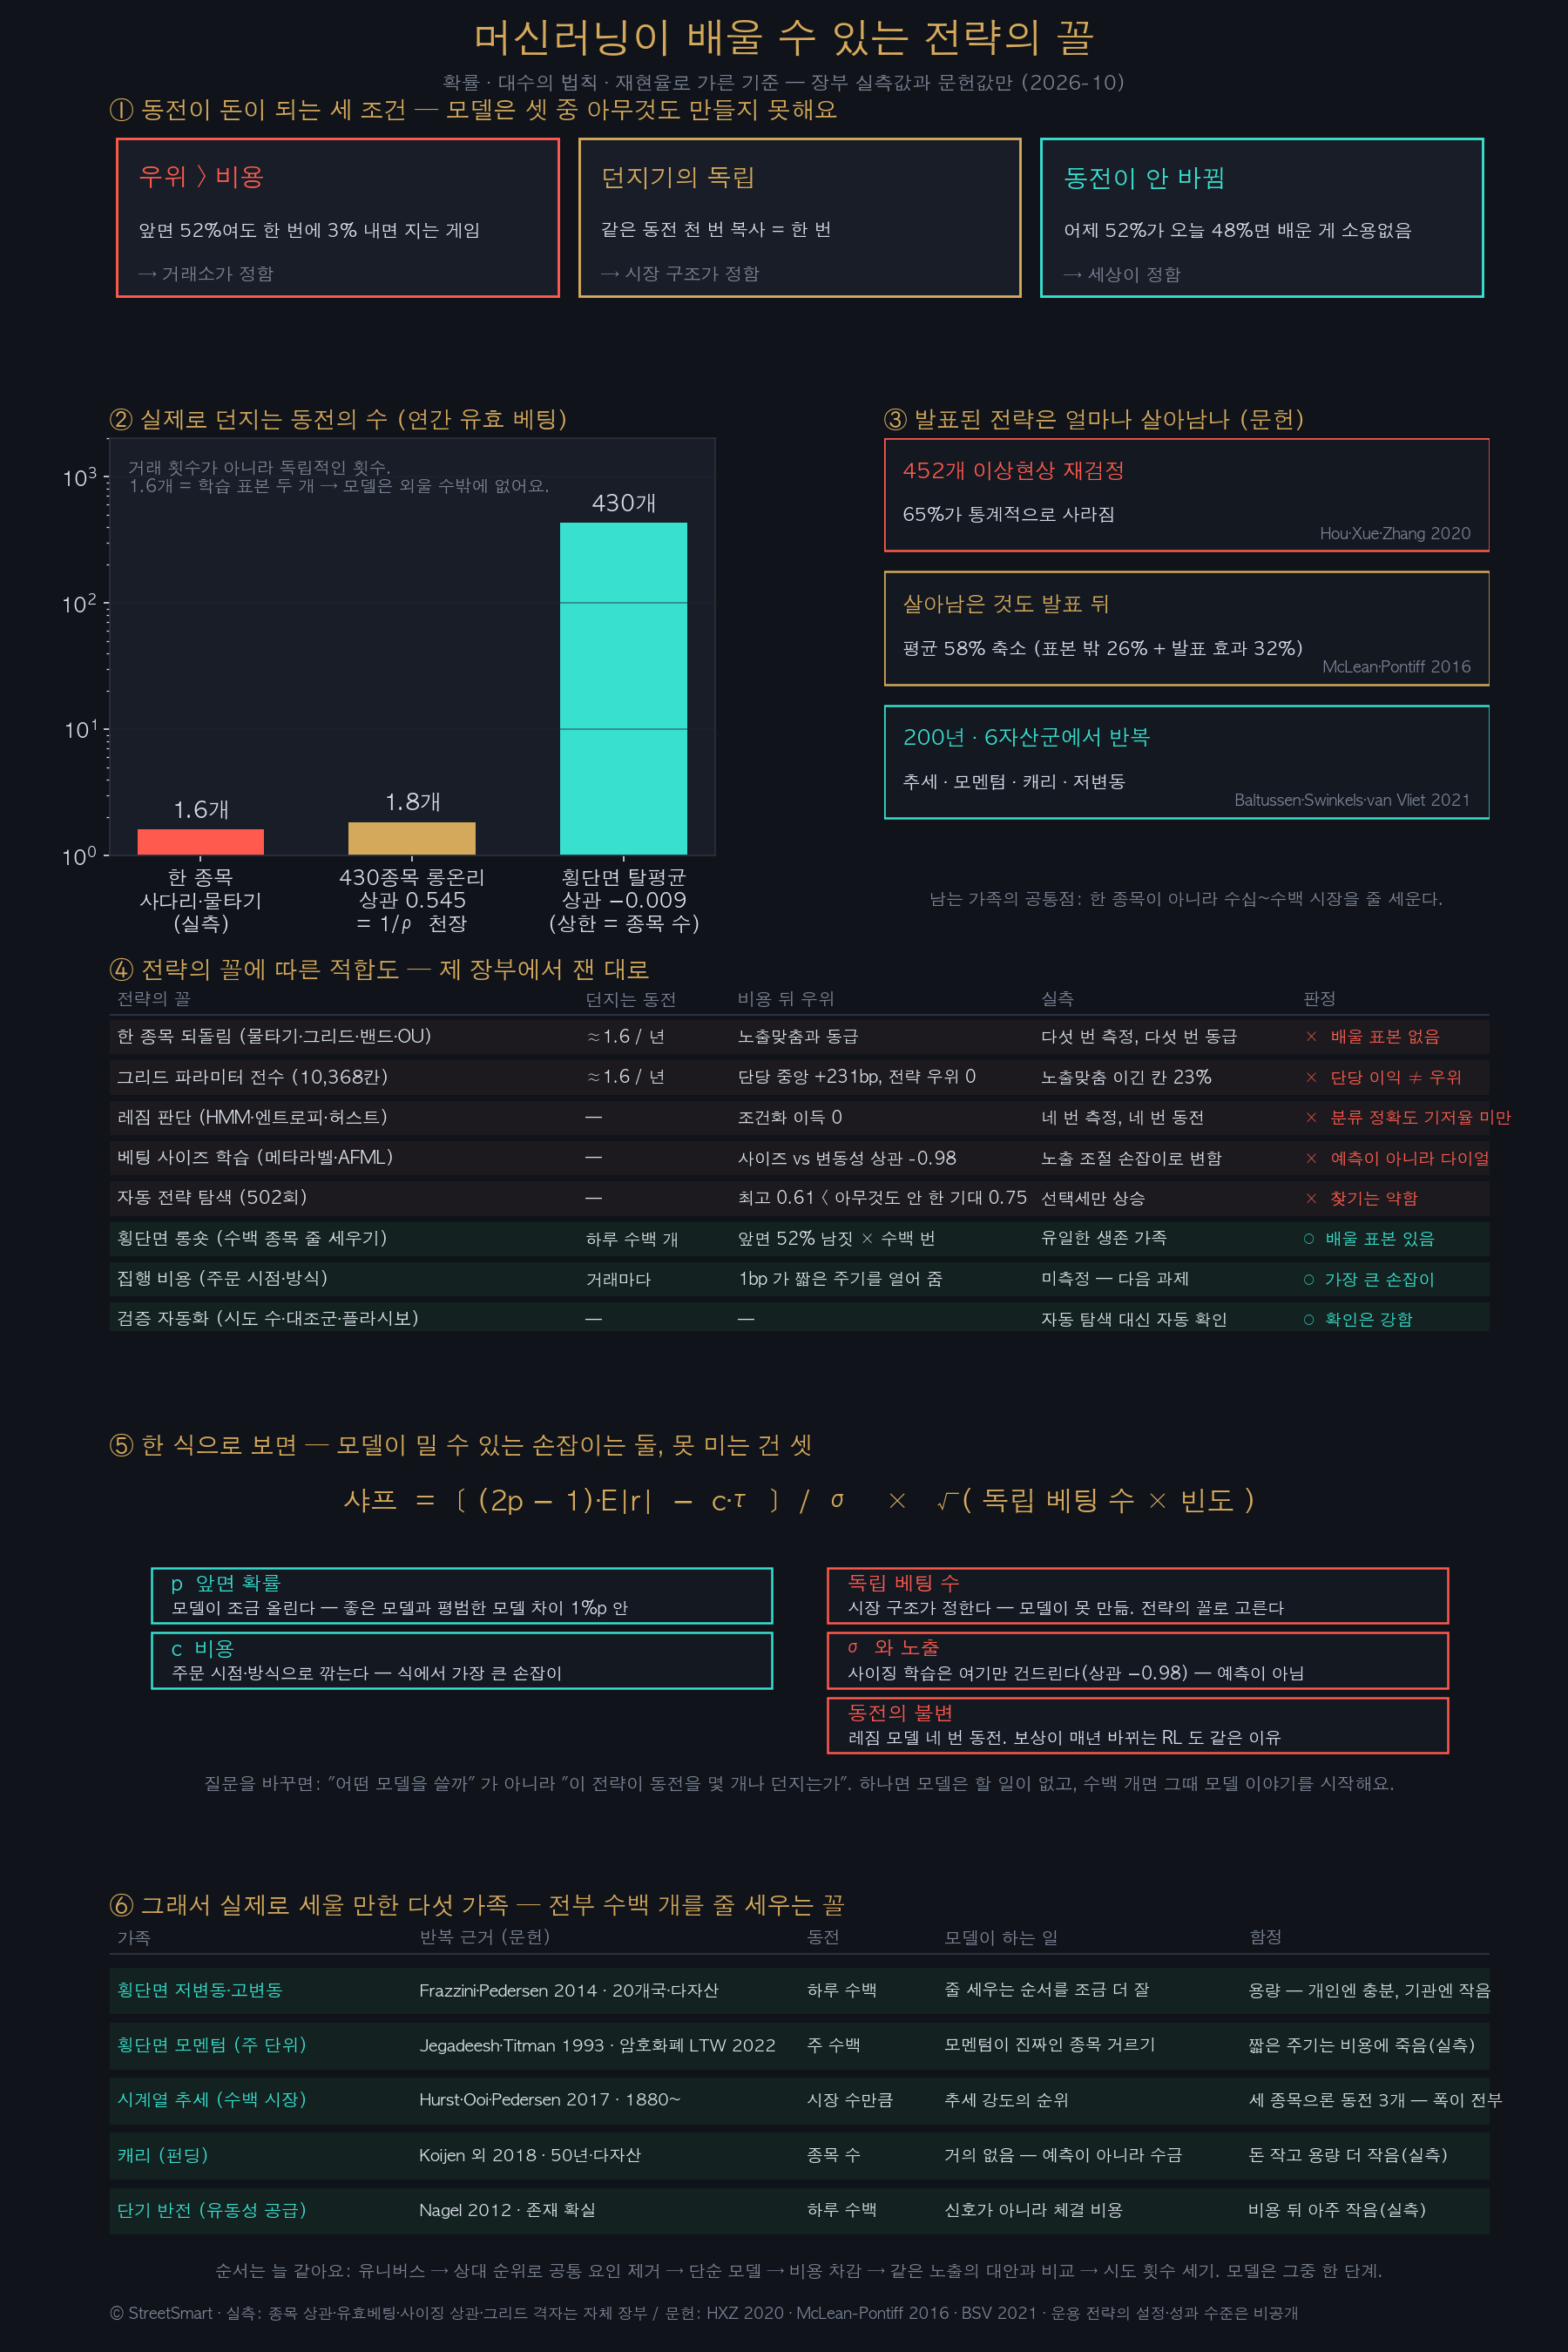
분석 전체를 한 장으로 정리했어요. 아래는 이 그림이 어떻게 나왔는지에 대한 이야기입니다.
동전 던지기로 돌아가서
지난 글에서 52.5%짜리 동전 이야기를 했어요. 한 번 던지면 도박이지만 2만 번 던지면 돈이 된다는 거요. 그런데 그 글의 진짜 요점은 “2만 번”이 아니라 “독립적인 2만 번”이었어요. 종목 430개를 사도 서로 0.545만큼 닮아 있으면, 실제로 던진 동전은 1.8개뿐이라는 계산이었죠.
머신러닝은 이 동전 이야기 위에 그대로 올라가요. 모델이 하는 일은 딱 하나예요. 동전의 앞면 확률을 조금 올리는 것. 50%짜리를 52%로, 52%를 53%로. 그게 전부예요. 그런데 그 “조금”이 돈이 되려면 세 가지가 이미 갖춰져 있어야 해요.
첫째, 우위가 비용보다 커야 해요. 앞면이 52%여도 던질 때마다 3%를 내면 지는 게임이에요. 둘째, 던지기가 독립이어야 해요. 같은 동전을 천 번 복사해서 던지는 건 한 번 던지는 거예요. 셋째, 동전이 바뀌지 않아야 해요. 어제 52%였던 동전이 오늘 48%면 배운 게 소용없죠.
여기서 불편한 사실 하나. 머신러닝은 이 셋 중 아무것도 만들어 주지 않아요. 비용은 거래소가 정하고, 독립성은 시장 구조가 정하고, 동전이 바뀌는 건 세상이 정해요. 모델은 이미 갖춰진 판 위에서 확률을 조금 밀 뿐이에요. 그래서 판부터 봐야 해요.
배울 표본이 없는 전략들
제가 제일 많이 시간을 쓴 쪽이 여기였어요. 한 종목을 놓고 “떨어지면 사고 오르면 판다”는 꼴의 전략들이요. 물타기, 분할매수, 그리드, 밴드, 평균회귀, 최근엔 OU 과정 적합까지. 이름은 다 다른데 다섯 번을 따로 재 봤더니 결과가 전부 같았어요. 같은 평균 노출로 그냥 들고 있는 것과 구분이 안 됐어요.
왜 그런지 숫자로 보면 분명해요. 한 종목짜리 전략은 거래를 수천 번 해도 실제로 던지는 동전이 연 1.6개쯤이에요. 가격이 한 경로로만 흐르니까요. 머신러닝 입장에서 이건 “학습 데이터가 1.6개”라는 뜻이에요. 피처를 열 개 넣든 백 개 넣든, 표본이 두 개면 외우는 것밖에 못 해요. 백테스트 안에서는 기막히게 잘 맞고, 밖에 나가면 동전이 돼요.
얼마 전엔 그리드 전략의 파라미터를 만 개 넘게 전부 돌려 봤어요. 단 하나하나는 평균 2% 넘게 벌어요. 그런데 전략 전체로 보면 우위가 0이에요. 벌어둔 단은 팔고, 손해 본 단은 재고로 남아서 고점에 노출이 쌓이거든요. “한 번에 2%”가 “전략이 번다”는 뜻이 아니라는 걸, 저도 숫자로 보고서야 믿었어요.
이런 꼴에 머신러닝을 얹으면 어떻게 되냐면요. 모델이 배우는 건 “언제 사면 오르는가”가 아니라 “언제 덜 사면 덜 잃는가”예요. 베팅 크기를 학습시켜 봤더니 모델의 사이즈가 변동성과 상관 −0.98이었어요. 변동성 크면 줄이고 작으면 늘리는, 노출 조절 손잡이가 된 거예요. 그건 예측이 아니죠. 레짐을 가르는 모델도 네 번 시도해서 네 번 다 동전이었어요.
그럼 배울 수 있는 꼴은
학계 쪽을 보면 힌트가 있어요. 발표된 트레이딩 이상현상 452개를 다시 재 본 연구가 있는데, 작은 종목을 빼면 65%가 통계적으로 사라져요. 살아남은 것도 발표 뒤 평균 58%가 줄고요. 그런데 끝까지 남는 가족이 있어요. 추세, 모멘텀, 캐리, 저변동. 200년치 데이터와 여섯 개 자산군에서 반복해서 나와요.
이 가족들의 공통점이 뭘까요. 많은 시장에 걸쳐 있다는 거예요. 한 종목에서 나오는 게 아니라, 수십 수백 개를 줄 세워서 위쪽과 아래쪽을 가르는 데서 나와요. 그리고 대부분 “왜 돈이 되는지”에 대한 설명이 있어요. 누군가 위험을 떠안거나, 누군가 구조적으로 사야만 해서요.
제 장부에서 유일하게 살아남은 전략도 정확히 이 꼴이에요. 암호화폐 수백 종목을 매 시간 줄 세워서 한쪽은 사고 한쪽은 파는 횡단면 전략이요. 종목 간 상관 0.545를 횡단면으로 빼내면 상관이 −0.009로 떨어져요. 그 순간 하루에 수백 개의 독립적인 동전이 생겨요. 그제야 모델이 배울 표본이 생기는 거예요. 한 번 던질 때 앞면 확률은 겨우 52% 남짓이지만, 그게 하루 수백 번이면 돈이 돼요.
정리하면 머신러닝이 어울리는 전략은 세 가지를 갖춘 꼴이에요. 폭이 넓고(수백 개 동전), 공통 요인이 빠져 있고(동전이 서로 독립), 비용 뒤에도 우위가 남는(동전을 던질 자격) 꼴이요. 이게 안 되면 모델을 바꿀 게 아니라 전략을 바꿔야 해요.
그래서 실제로 뭘 세우면 되느냐
여기까지 읽으면 당연히 이 질문이 나와요. “그럼 구체적으로 어떤 전략이냐.” 제 장부와 문헌을 겹쳐서 추리면 다섯 가족이 남아요. 공통점은 전부 수백 개를 줄 세우는 꼴이고, 각각 머신러닝이 할 일이 조금씩 달라요.
하나, 횡단면 저변동·고변동. 변동성이 큰 종목이 작은 종목보다 못하다는 현상이에요. 주식·채권·원자재에서 수십 년 반복됐고(Frazzini·Pedersen 2014), 제 장부에서 유일하게 살아남은 전략의 실체도 이거였어요. 암호화폐 수백 종목을 매 시간 변동성으로 줄 세워서 위는 팔고 아래는 사는 거요. 머신러닝의 자리는 “줄 세우는 순서”예요. 변동성 하나로만 세우는 것보다 유동성·펀딩·최근 수익을 같이 보는 모델이 순서를 조금 더 잘 매겨요. 조금이요. 그 조금이 하루 수백 번이라 되는 거고요.
둘, 횡단면 모멘텀. 최근 몇 주 잘 오른 쪽이 몇 주 더 간다는 거예요. 1993년 논문 이후 거의 모든 자산군에서 반복됐고, 암호화폐에서도 주 단위로 확인된 연구가 있어요(Liu·Tsyvinski·Wu 2022). 저는 더 짧은 주기에서만 재 봤고 거기선 비용을 못 넘었어요. 주 단위는 아직 안 쟀고, 그래서 제 다음 후보예요. 여기서 머신러닝은 “어느 종목의 모멘텀이 진짜인지”를 거르는 일을 해요.
셋, 시계열 추세. 각 종목이 자기 과거 대비 오르고 있으면 사고 내리고 있으면 파는 거예요. 1880년대까지 거슬러 올라가는 증거가 있어요(Hurst·Ooi·Pedersen 2017). 단, 조건이 있어요 — 수십 개 이상의 시장에 동시에 걸어야 해요. 저는 세 종목으로 재 봤다가 아무것도 못 찾았는데, 그게 전략이 없어서가 아니라 동전이 세 개뿐이어서였어요. 수백 개 무기한물에 걸면 이야기가 달라질 수 있고, 이것도 재 볼 목록에 있어요.
넷, 캐리. 들고만 있어도 들어오는 돈을 모으는 거예요. 암호화폐에선 펀딩비가 그거예요. 통화·채권·원자재에서 50년 반복됐고(Koijen 외 2018), 제가 잰 것도 작지만 분명히 양수였어요. 다만 두 가지 함정이 있어요. 돈이 작고, 담을 수 있는 규모가 더 작아요. 그리고 머신러닝이 할 일이 거의 없어요 — 캐리는 예측이 아니라 수금이거든요.
다섯, 단기 반전. 며칠 급하게 움직인 종목이 되돌아오는 거예요. 유동성을 공급하는 대가라서 존재 자체는 확실한데(Nagel 2012), 비용을 빼면 남는 게 아주 작아요. 제가 2일 주기로 재 본 것도 “있긴 한데 수천 개 설정 중에 고른 거라 잡음과 구분이 안 되는” 수준이었어요. 여기서 머신러닝이 도울 자리는 신호가 아니라 비용이에요. 더 싸게 체결하는 쪽이요.
이 다섯을 세울 때 순서는 늘 같아요. 수백 종목 유니버스를 만들고, 종목을 서로 상대 순위로 바꿔서 공통 요인을 빼고, 단순한 모델로 순서를 매기고, 비용을 뺀 뒤에 성과를 보고, 같은 노출의 단순 대안과 비교하고, 시도 횟수를 세요. 모델은 이 일곱 단계 중 세 번째 하나예요.
그리고 솔직한 주석 하나. 이 꼴의 전략은 담을 수 있는 돈에 한계가 있어요. 수백 종목에 조금씩 걸어야 하니까 유동성 작은 종목이 병목이 돼요. 제가 잰 바로는 개인이 다루기엔 충분하고 기관이 다루기엔 작은 규모예요. 그게 아마 이 가족이 아직 살아 있는 이유 중 하나일 거예요.
반대로 안 세울 목록도 적어 둘게요. 한 종목 되돌림(물타기·그리드·밴드), 레짐 스위칭, 베팅 사이즈 학습, 전체를 강화학습으로 묶기. 전부 제가 직접 재서 닫은 것들이고, 이유는 앞에서 말한 그대로예요 — 동전이 하나거나, 동전이 바뀌거나, 배우는 게 예측이 아니라 노출이거나.
머신러닝이 설 자리, 못 설 자리
그러면 이런 꼴의 전략 안에서 머신러닝은 어디에 들어가느냐. 제가 재 본 바로는 세 군데예요.
하나, 신호. 수백 종목을 줄 세우는 순서를 조금 더 잘 매기는 일. 여기서 “조금”이 중요해요. 제 경험으론 좋은 모델과 평범한 모델의 차이가 앞면 확률 1%p 안이었어요. 대신 그 1%p가 하루 수백 번 곱해지니까 의미가 있는 거예요.
둘, 비용. 언제 어떻게 주문을 넣느냐로 수수료와 슬리피지를 깎는 일. 이건 제가 아직 제대로 안 해 본 영역인데, 식을 보면 여기가 제일 큰 손잡이예요. 비용이 1bp 줄면 전에는 못 쓰던 짧은 주기가 열리거든요.
셋, 검증. 모델이 전략을 찾게 하는 게 아니라, 사람이 낸 가설을 모델이 검증하게 하는 일. 시도 횟수를 세고, 노출을 맞춘 대조군을 세우고, 플라시보를 돌리는 걸 자동으로요. 제가 502번 자동 탐색을 시켜 봤는데, 찾은 최고가 아무것도 안 한 기대값보다 낮았어요. 기계는 찾는 데는 약하고 확인하는 데는 강해요.
못 설 자리도 분명해요. 베팅 크기는 앞서 말한 대로 노출 손잡이가 되고요. 레짐 판단은 동전이고요. 전체를 강화학습 하나로 묶는 건, 보상이 매년 바뀌고 에피소드가 두 개뿐인 게임을 배우라는 거라 저는 안 해요.
질문을 바꾸면
“어떤 모델을 쓸까”는 제가 처음 몇 년 동안 붙잡고 있던 질문이었어요. 지금은 다른 질문을 먼저 해요. “이 전략이 동전을 몇 개나 던지는가.” 하나면 머신러닝은 할 일이 없고, 수백 개면 그때부터 모델 이야기를 시작해요.
모델이 똑똑해져서 되는 게 아니라, 문제가 동전을 던질 수 있는 꼴이어야 돼요. 그게 제가 몇 년 걸려 배운 전부예요.
이 글의 수치는 전부 직접 잰 값이거나 출처가 있는 문헌값이에요. 종목 간 상관 0.545와 탈평균 뒤 −0.009, 유효 베팅 1.6~1.8개, 사이징 모델의 상관 −0.98, 그리드 만 칸은 제 장부에서 나왔고, 452개 중 65%(Hou·Xue·Zhang 2020), 발표 후 58% 축소(McLean·Pontiff 2016), 200년·여섯 자산군(Baltussen·Swinkels·van Vliet 2021), 저변동(Frazzini·Pedersen 2014), 암호화폐 모멘텀(Liu·Tsyvinski·Wu 2022), 추세(Hurst·Ooi·Pedersen 2017), 캐리(Koijen·Moskowitz·Pedersen·Vrugt 2018), 반전(Nagel 2012)은 논문이에요. 운용 중인 전략의 구체 설정과 성과 수준은 공개하지 않아요.


답글 남기기